NumPy 基本介绍 | reshape 和 transpose 的理解
写在前面
如果觉得 NumPy 的 broadcasting、transpose 等等操作很难理解,请不要怀疑自己。我想这是 NumPy 设计的问题。
虽然 NumPy 已经在一定程度上成为了行业标准,但我认为这个库的设计是失败的。一个最简单的例子是,默认开启的 broadcasting 让许多本来可以通过报错发现问题的 bug 变得难以发现。
NumPy 只是一个工具库而已,并非什么公认的标准。我认为 AI 发展到现在的阶段,费尽心思学习一个基础计算的工具库是没有意义的。本文依然更新的唯一目的是希望大家能够顺利通过一些涉及 NumPy 的考试。
——作者于 2026 年 10 月 8 日
什么是 NumPy?
NumPy(Numerical Python 的缩写)是一个用于科学计算的开源 Python 库。它提供了支持大型多维数组和矩阵的高性能数据结构,以及大量用于操作这些数组的数学函数。NumPy 是数据科学、机器学习和数值分析等领域的基础工具之一。
安装
pip install numpy
# or
pip3 install numpy
多维数组
NumPy 提供的主要数据结构是 ndarray(N-Dimensional Array),它是一个多维数组对象:
import numpy as np

a = np.array([[1, 2, 3], [4, 5, 6]])

print(a)
'''
输出:
[[1 2 3]
 [4 5 6]]
'''

print(a.shape)  # 输出数组的形状 (2, 3)
print(a.ndim)  # 输出数组的维度 2
print(a.dtype)  # 输出数组的数据类型 int64
快速生成数据
np.zeros((2, 3))  # 创建一个 2x3 的零矩阵
np.ones((3, 4))   # 创建一个 3x4 的全一矩阵
np.arange(0, 10, 2)  # 创建一个从 0 到 10,步长为 2 的数组
np.linspace(0, 1, 5)  # 创建一个从 0 到 1 的等间隔数组,共 5 个元素
np.random.rand(2, 3)  # 创建一个 2x3 的随机数组,元素在 [0, 1) 之间
数据类型
NumPy 默认使用 float64 作为浮点数的数据类型,因此在上例中,np.zeros((2, 3)) 创建的数组元素类型为 float64:
[[0. 0. 0.]
 [0. 0. 0.]]
可以通过 dtype 参数指定其他数据类型:
np.zeros((2, 3), dtype=int) # 创建一个 2x3 的整数零矩阵索引和切片
NumPy 支持类似于 Python 列表的索引和切片操作:
a = np.array([[1, 2, 3], [4, 5, 6]])
print(a[0, 1])  # 输出 2(等同于 a[0][1] )
print(a[:, 1])  # 输出第二列 [2 5]
print(a[:, :2])  # 输出 [[1 2]
                 #       [4 5]]
以第 3 行为例,具体而言,: 表示选择该维度的所有元素,而 1 则表示选择该维度的第 1 个索引位置的元素(注意索引从 0 开始)。因此,a[:, 1] 表示选择数组 a 的所有行的第 1 列。
关于 [:, 1] 语法的说明
通过类似下面这样的语法,我们可以无限扩展切片操作:
class MyMatrix:
    def __init__(self, data):
        self.data = data
    def __getitem__(self, idx):
        rows, col = idx
        print(rows)  # 输出 slice(None, None, None)
        print(col)  # 输出 1
        return [row[col] for row in self.data[rows]]

m = MyMatrix([[1, 2, 3], [4, 5, 6], [7, 8, 9]])

print(m[:, 1])  # 输出 [2, 5, 8]
数据统计
NumPy 提供了丰富的统计函数:
a = np.array([1, 2, 3, 4, 5, 6])
print(np.sum(a))        # 输出所有元素的和 21
print(np.mean(a))       # 输出平均值 3.5
print(np.median(a))     # 输出中位数 3.5
print(np.std(a))        # 输出标准差 1.707825127659933
数学运算
NumPy 支持对数组进行元素级的数学运算:
a = np.array([1, 2, 3])

print(a * 2)  # 输出 [2 4 6]

b = np.array([4, 5, 6])

print(a + b)  # 输出 [5 7 9]
print(a * b)  # 输出 [ 4 10 18]
更进一步,NumPy 还支持矩阵运算:
A = np.array([[1, 2], [3, 4]])
B = np.array([[5, 6], [7, 8]])

print(np.dot(A, B))  # 矩阵的点积
Broadcasting(广播)
(此部分内容搬运自知乎 @Vector:浅谈Numpy 中的Broadcast)
感性理解
我们定义:
a = np.array([[ 0,  1,  2],
              [ 3,  4,  5],
              [ 6,  7,  8],
              [ 9, 10, 11]])
b = np.array([0, 1, 2])
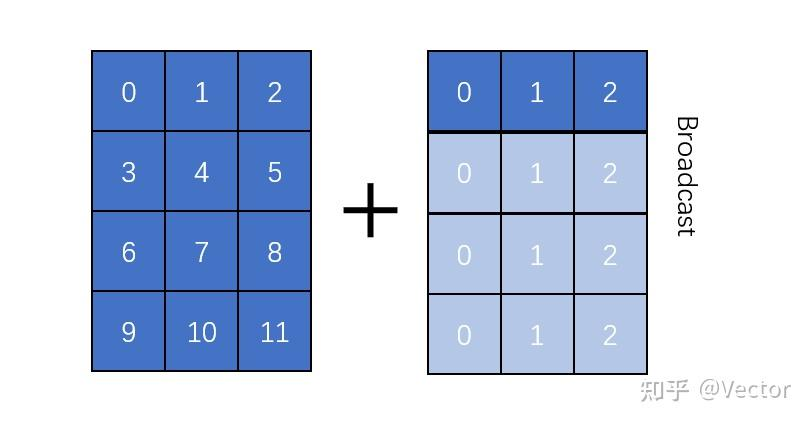
此时我们运算 a + b,会得到这样的结果:
array([[ 0,  2,  4],
       [ 3,  5,  7],
       [ 6,  8, 10],
       [ 9, 11, 13]])
他们的相加与 Broadcast 如下图所示:
详细解释
到底 Broadcast 的规则是什么呢?官方的总结如下:
In order to broadcast, the size of the trailing axes for both arrays in an operation must either be the same size or one of them must be one.
为了广播,操作中两个数组的后轴的大小必须相同,或者其中一个必须是
简单来说,就是从末尾开始对比两个数组的 shape,必须一致或者为
具体规则如下(以下规则可以按照任意顺序组合使用,直至运算合法):
让所有输入数组都向其中形状最长的数组看齐,形状中不足的部分都通过在前面(左侧)补 。比如计算
a+b,其中a.shape=(4, 3)、b.shape=(3, ),那么数组b将被 broadcast 为b.shape=(1, 3),然后再进行运算。如果两个数组的形状在任何维度上均不匹配,但是某个数组中某一个维度为 ,则该维度中形状为 的数组将被拉伸以匹配另一个数组对应维度形状。比如计算a+b,其中
a.shape=(1, 3)、b.shape=(3, 1),那么根据规则 2,这两个数组会 boradcast 为a.shape=(3, 3)、b.shape=(3, 3)如果两个数组的形状在任何维度上均不匹配,且均没有等于1的维度,则会报错。
扩展
除加法外,Broadcast 还可以用于其他运算,比如减法、乘法、除法等。只要满足上述规则,NumPy 就会自动进行广播操作,使得不同形状的数组能够进行元素级的运算。
例如计算 a * b,其中 a.shape=(4, 3)、b.shape=(3, ),则 b 会被 broadcast 为 b.shape=(1, 3) b.shape=(4, 3),然后再进行乘法运算,得到的结果为:
array([[ 0,  1,  4],
       [ 0,  4, 10],
       [ 0,  7, 16],
       [ 0, 10, 22]])
Reshape 和 Transpose
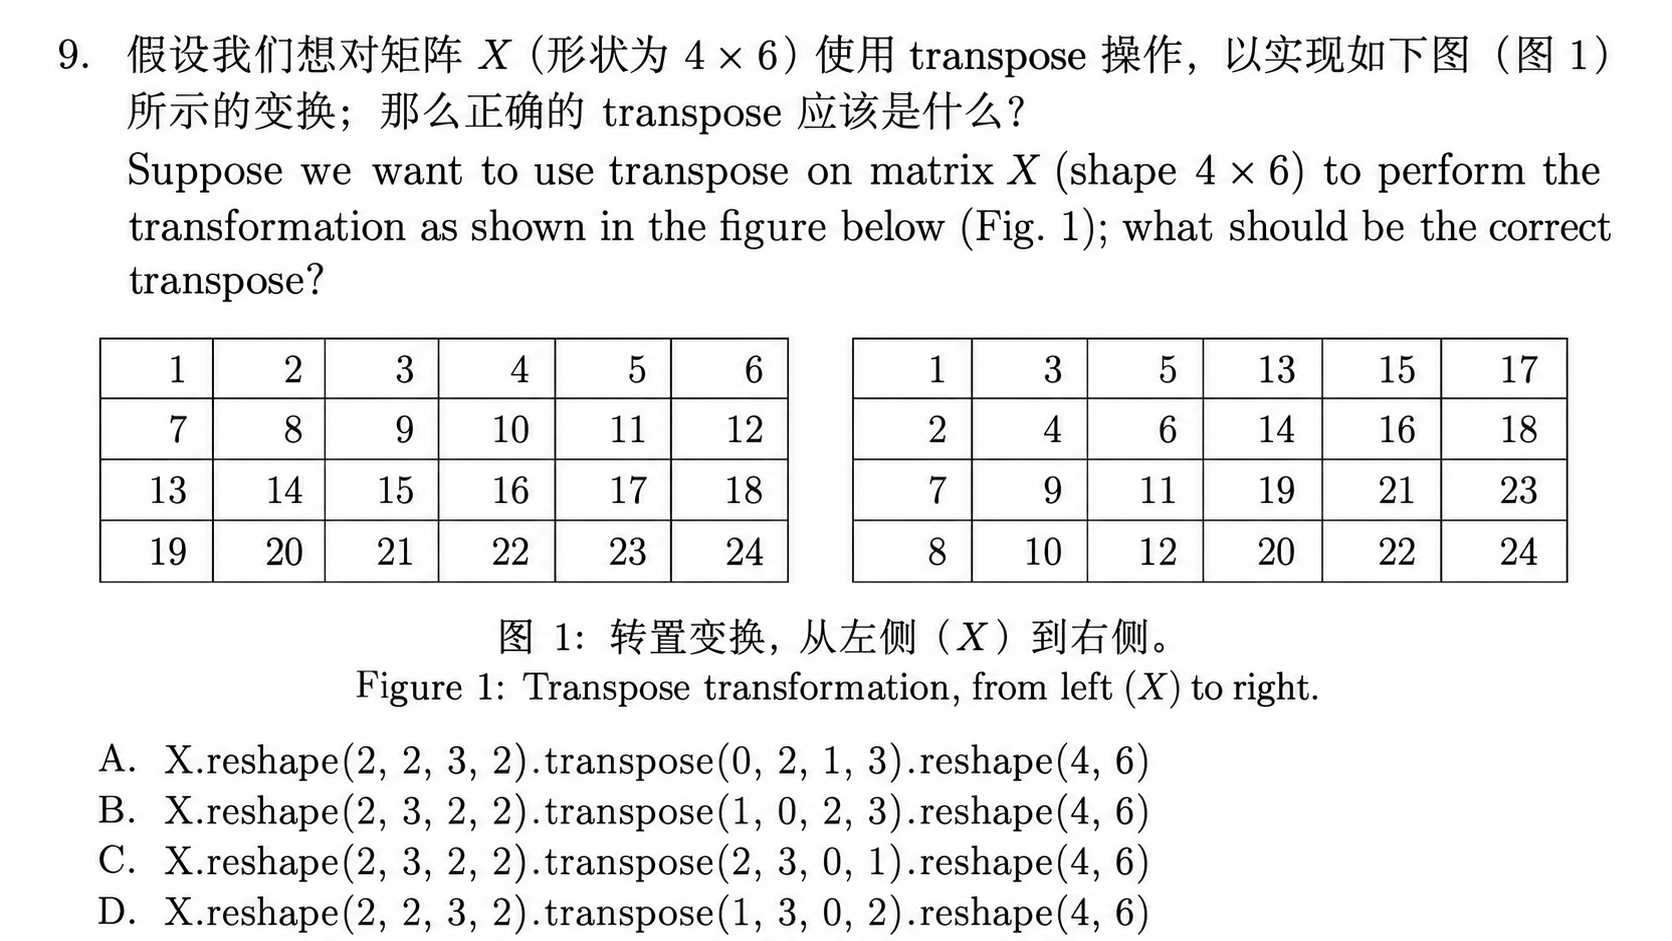
这里直接通过一道题来理解。
reshape
首先我们先来了解一下 reshape,它的作用是改变数组的形状,但不改变数据本身。比如:
a = np.array([[1, 2, 3], [4, 5, 6]])
print(a.reshape(3, 2))

'''输出:
[[1 2]
 [3 4]
 [5 6]]
'''
需要注意的是,无论你的数组原本是什么形状,它们在内存中都是连续存储的。上例中,无论是在 reshape 前后,内存中都存在连续的元素:[1, 2, 3, 4, 5, 6]。所以 reshape 只是改变了我们对数据的视图,而不改变数据本身,也不改变数据的顺序。
在本题的设定中, 形状的 X 矩阵可以通过下面的方式获得:
_X = np.array([1, 2, 3, ..., 24])
X = _X.reshape(4, 6)
而鉴于我们已经知道了 D 是正确答案,我们此处给出 X.reshape(2, 2, 3, 2) 的结果:
array([[[[ 1,  2],
         [ 3,  4],
         [ 5,  6]],
        [[ 7,  8],
         [ 9, 10],
         [11, 12]]],
       [[[13, 14],
         [15, 16],
         [17, 18]],
        [[19, 20],
         [21, 22],
         [23, 24]]]])
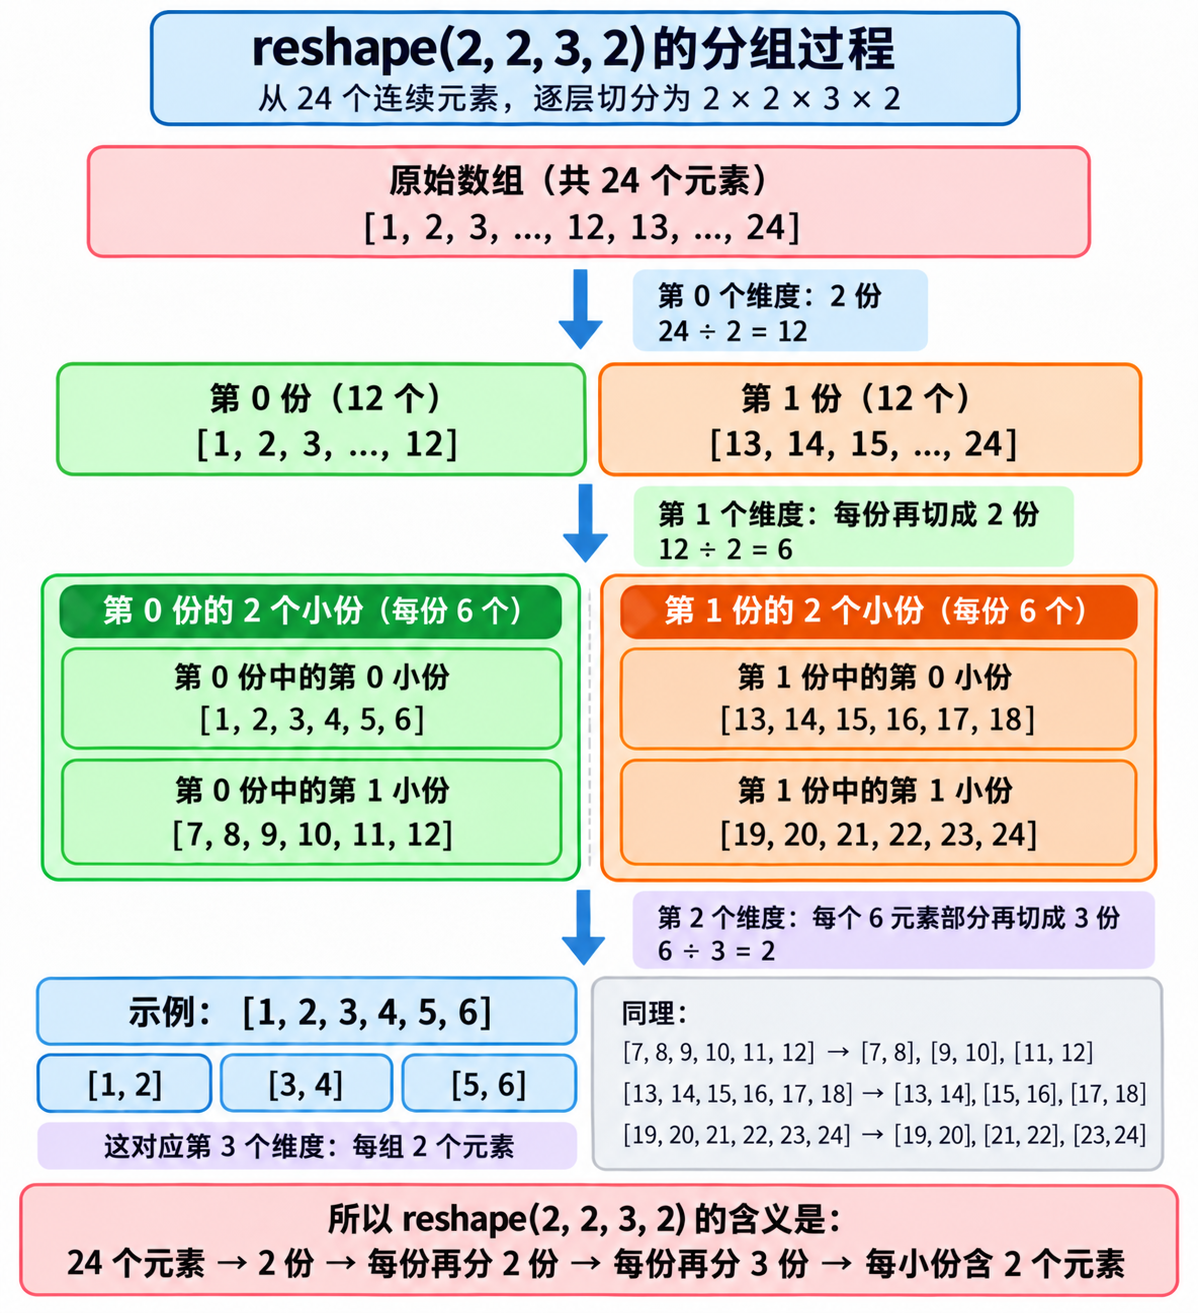
你可以理解为:
(2, 2, 3, 2)中的第一个2把原本的[1, 2, 3, ..., 12, 13, ..., 24]分成了[1, 2, 3, ..., 12]和[13, ..., 24]两个部分;- 第二个
2把每个部分再分成了两部分,对于[1, 2, 3, ..., 12],结果即[1, 2, 3, 4, 5, 6]和[7, 8, 9, 10, 11, 12]; - 第三个
3把[1, 2, 3, 4, 5, 6]再分成了[1, 2],[3, 4],[5, 6]三个部分; - 最后一个
2表示最终每个部分中有两个元素。
来看看 ChatGPT 做的这张丑丑的图:
索引
为了方便下文的讲述,我们需要理解上面图中的结果所涉及的索引。这一步不难,只需要按照上图的分割顺序,依次给每个元素标上索引即可。
例如:
4的索引是(0, 0, 1, 1),可以通过X[0][0][1][1]访问14的索引是(1, 0, 0, 1),可以通过X[1][0][0][1]访问
transpose
transpose 操作可以改变数组的维度顺序。
对于二维来说,这件事情很好理解,只需要把矩阵的行和列互换即可。例如:
对于更高维度,此处我不给出严格定义,只是给出我个人的理解。
我们来具体看看题目中 D 选项给出的 X.reshape(2, 2, 3, 2).transpose(1, 3, 0, 2) 这一操作的过程。
首先我们先理解这里的 transpose(1, 3, 0, 2),它的意思是:新的 array 的第 维,分别对应原 array 的第 维度。这句话很抽象,我们一点一点来看。
这里有一个 Claude 生成的 UI 帮助你理解此题中的 transpose 操作。你可以先打开这个 UI 操作一下,然后对照着回来重新阅读这部分内容。下面的截图来自此 UI。
注意
为了方便展示,UI 中以及下面的截图中所有列表都按照 reshape 为 的样式展示,并且隐去了真实的分组嵌套关系。实际上,数据在内存中仍是线连续存储的。
我们可以从前往后依次来看四个维度的变化,第一个变化新 array 的第 维是原 array 的第 维蕴含两层意思:
- 新 array 的第 维的长度是原 array 的第 维的长度,即 ;
- 我们要使用每个元素原本的第 维的索引,去划分元素在新 array 中的第 维的位置。
如图所示,所有灰色元素对应的在原数组的坐标都满足 (*, 0, *, *),所以它们在新 array 中的第 维的索引都是 ;所有橙色元素对应的在原数组的坐标都满足 (*, 1, *, *),所以它们在新 array 中的第 维的索引都是 。
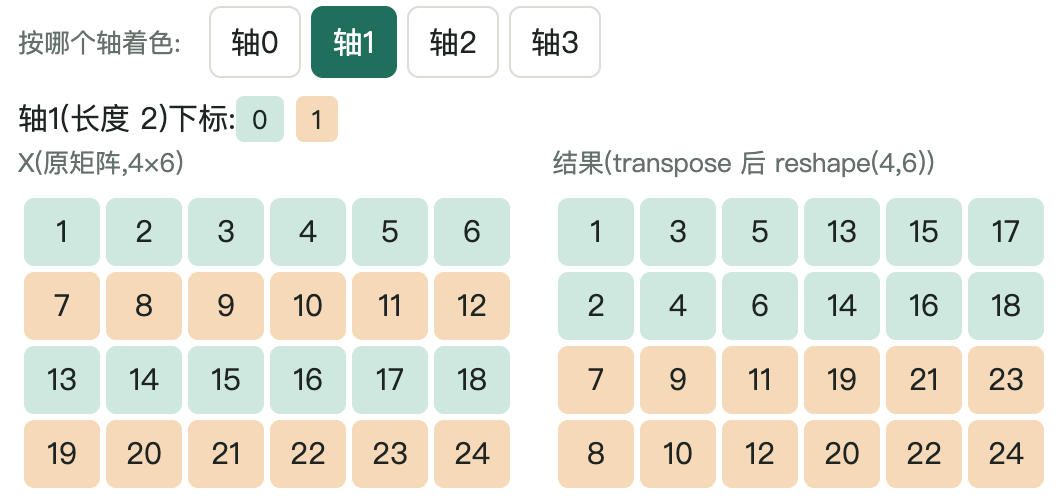
然后,我们现在关注新 array 的第 维索引为 的所有元素(灰色元素),暂时记为 T = [1, 2, ..., 6, 13, 14, ..., 18](共 12 个)。
下面我们要进行的操作是:新 array 的第 维是原 array 的第 维,所以我们要使用每个元素原本的第 维的索引,去划分元素在新 array 中的第 维的位置:
- 原 array 的第 维长度也为 ,所以新 array 的第 维长度也为 ;
- 我们从
T中取出所有原 array 第 维索引为 的元素T0 = [1, 3, 5, 13, 15, 17],它们在新 array 中的第 维索引都是 ;同理,取出所有原 array 第 维索引为 的元素T1 = [2, 4, 6, 14, 16, 18],它们在新 array 中的第 维索引都是 。
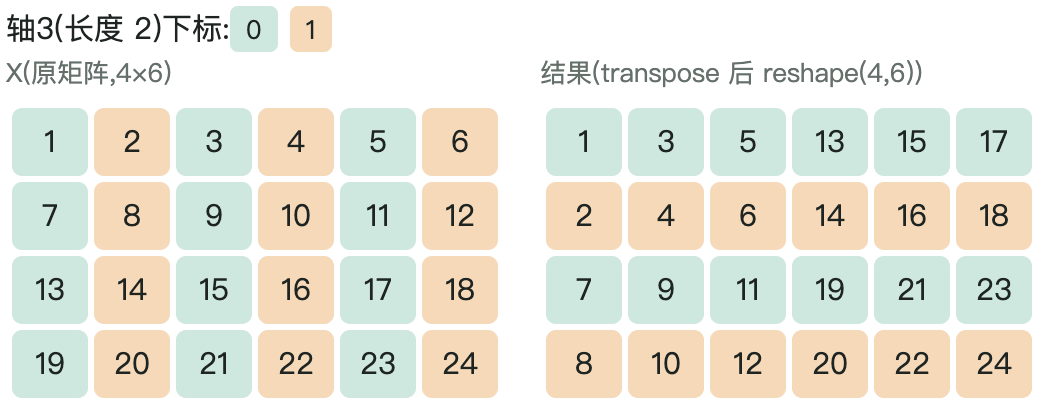
后面的操作类似,最终我们可以得到原题中右侧的数组。
如何做题
说是如何做题,其实也是当我们想出我们真正想要的数组样式后,如何去实现。
首先我们要找出新 array 的分组方式,换言之,就是新数组的四维 shape 长什么样子。看了上面那个“ChatGPT 做的丑丑的图”之后我们意识到,划分维度就是把一组元素一刀一刀切开。因此我们在这里也只需要找到新的 array 里面这些元素是如何被切开的即可。
先看第一行,不难发现,按照 [1, 3, 5] 和 [13, 15, 17] 来把这些元素划分成两组是最合理的(这里应该是从最开头的元素开始,找到连续的最长等差数列;找到后你会发现后面一定存在一个等长的等差数列,以此类推)。
我们随机从划分出的一组中挑出两个元素,例如 1 和 3,写出它们在原 array 中的索引 (0, 0, 0, 0) 和 (0, 0, 1, 0)。我们发现,这两个索引有且仅有第 维不同,因此新 array 中最后一个维度、也是变化最快的维度,是原 array 的第 维。于是我们知道了,transpose 操作中的最后一个参数应该是 ,即 transpose(_, _, _, 2)。
(错误做法)如果你还想让 1 和 2 一组,请点我继续阅读
也许你会先想到,我们可以把左上角的 看成一组。但这是错误的,因为这些元素在内存中是线性存储的:
[ 1,  3,  5, 13, 15, 17,
  2,  4,  6, 14, 16, 18,
  7,  9, 11, 19, 21, 23,
  8, 10, 12, 20, 22, 24]
我们只能按线性顺序去组合元素。
而后,我们注意到下一个分组应该是 [[1, 3, 5], [13, 15, 17]] 和 [[2, 4, 6], [14, 16, 18]]。以 [[1, 3, 5], [13, 15, 17]] 为例,我们再比较 1 和 13 的原 array 索引 (0, 0, 0, 0) 和 (1, 0, 0, 0)。我们发现,这两个索引有且仅有第 维不同,因此新 array 中倒数第二个维度、也是变化第二快的维度,是原 array 的第 维。于是我们知道了,transpose 操作中的倒数第二个参数应该是 ,即 transpose(_, _, 0, 2)。
以此类推,即得原题答案。
相关信息
这里如果你不选
1和13也可以,只要确保选出的两个元素在[[1, 3, 5], [13, 15, 17]]这个数组中的第 个索引不同即可(换言之,不同时在[1, 3, 5]或[13, 15, 17]中)。例如你选择
1和15,它们的原 array 索引分别是(0, 0, 0, 0)和(1, 0, 1, 0),它们第 维和第 维均不同,但是原数组的第 维我们已经取用过了,因此依然可以得到倒数第二个维度是原 array 的第 维。为什么我们新得到的分组是
[[1, 3, 5], [13, 15, 17]],而不把[2, 4, 6]和[14, 16, 18]也放进来呢?- 方法一:原 array 的 shape 是
(2, 2, 3, 2),新 array 的四个维度的长度也必须从这四个数字里面不重复地选取,而前面组合[1, 3, 5]的时候已经把唯一一个长度不为 的维度选取了,因此其它维度的长度都只能为 ; - 方法二:你也可以考虑元素
1和13后再考虑元素1和2,你会发现它们的原 array 索引产生差异的维度不相同,因此我们无法把它们放在同一个维度中。
- 方法一:原 array 的 shape 是